


지난 글에서 상담 챗봇의 컨텍스트에 환불 규정을 넣었다. 규정 문서가 한 장일 때 얘기다.
쇼핑몰이 커지면 챗봇이 알아야 할 문서도 늘어난다. 이런 쇼핑몰을 하나 떠올려 보자.
- 환불, 교환, 배송 규정 문서 10여 개
- 자주 묻는 질문 300개
- 상품 상세 페이지 2만 개
- 고객 리뷰와 문의 내역 50만 건
이걸 전부 컨텍스트에 넣을 수는 없다. 넣을 수 있다 해도 지난 글에서 본 것처럼 비싸고 느리고, 길어질수록 모델이 중요한 걸 놓친다.
그래서 질문이 들어올 때마다 그 질문에 필요한 조각만 찾아서 넣는다. 이게 RAG다.
필요한 페이지만 펼쳐 주기
RAG는 Retrieval-Augmented Generation의 줄임말이다. 검색(Retrieval)으로 보강한(Augmented) 생성(Generation).
이름은 2020년 Facebook AI Research(현 Meta AI)의 패트릭 루이스(Patrick Lewis) 등이 낸 논문에서 나왔다. 논문은 검색기와 생성 모델을 함께 학습시키는 구조였지만, 지금은 더 넓은 뜻으로 쓴다. 질문과 관련된 문서를 찾아서 프롬프트에 붙이고, 모델이 그걸 읽고 답하게 하는 방식 전체를 RAG라고 부른다.
시험으로 치면 오픈북 시험이다. 책 전체를 외우게 하지 않고, 문제에 맞는 페이지를 펼쳐 준다.
영수가 챗봇에 묻는다.
운동화 사이즈가 안 맞는데 바꿀 수 있어요?
챗봇은 문서 수십만 건 중에서 교환 규정의 한 문단을 찾아 컨텍스트에 넣는다.
아래 문서를 참고해서 질문에 답해줘.
문서에 없는 내용이면 모른다고 답해줘.

[교환 규정 제3조]
상품 수령 후 7일 이내, 착용 흔적이 없는 경우 같은 상품의 다른 사이즈로 1회 무료 교환할 수 있다.

[질문]
운동화 사이즈가 안 맞는데 바꿀 수 있어요?
모델은 이제 추측하지 않고 문서를 읽고 답한다. 규정이 바뀌면 문서만 바꾸면 되고, 모델을 다시 학습시킬 필요도 없다. 어느 문서를 보고 답했는지 출처를 같이 보여줄 수도 있다.
찾으려면 미리 잘라 둬야 한다
원리는 간단하다. 어려운 건 "질문에 맞는 문단을 찾는다"는 부분이다.
영수는 "사이즈가 안 맞는데 바꿀 수 있어요?"라고 물었다. 교환 규정에는 "다른 사이즈로 1회 무료 교환"이라고 적혀 있다. 겹치는 단어는 "사이즈" 하나다. 다른 고객은 "치수 변경 되나요?"라고 물을 수도 있다. 이러면 겹치는 단어가 하나도 없다.
그래서 RAG는 문서를 미리 손질해 둔다. 흐름은 두 개로 나뉜다.
[ 미리 해 두기 ]  문서가 바뀔 때마다

  문서 → 청크로 자르기 → 임베딩 만들기 → 벡터 DB에 저장


[ 질문이 오면 ]  매번

  질문 → 임베딩 → 비슷한 청크 찾기 → 컨텍스트에 넣기 → LLM → 답변 + 출처
청크(Chunk) 는 문서를 자른 조각이다. 교환 규정 중 제3조 한 문단만 골라 넣으려고 자른다. 몇백 자에서 천 자 정도로 자르는데, 너무 작으면 문맥이 사라지고 너무 크면 쓸데없는 내용이 섞인다. 문장이 경계에서 잘리지 않게 앞뒤를 조금씩 겹쳐 자르기도 한다.
임베딩(Embedding) 은 텍스트를 숫자 목록(벡터)으로 바꾼 것이다. 뜻이 비슷한 문장은 비슷한 숫자가 나온다.
"치수 변경 되나요?"           → [0.12, -0.48, 0.33, ...]
"다른 사이즈로 교환할 수 있다"  → [0.11, -0.45, 0.35, ...]  ← 가깝다
"배송은 평일 오후 2시 출고"     → [-0.67, 0.21, -0.09, ...] ← 멀다
"치수 변경"과 "사이즈 교환"은 글자가 하나도 겹치지 않지만 임베딩으로 바꾸면 가까이 놓인다. 단어가 아니라 뜻으로 찾을 수 있는 이유다.
벡터 DB 는 이 벡터들을 저장해 두고, 질문 벡터와 가까운 것을 빨리 찾아 주는 데이터베이스다. Pinecone, Chroma 같은 전용 DB도 있고, PostgreSQL의 pgvector처럼 기존 DB에 붙이는 확장도 있다.
코드로 보면
랭체인과 랭그래프 글에서 다룬 LangChain으로 두 흐름을 그대로 옮겨 보자.
from langchain.chat_models import init_chat_model
from langchain_core.documents import Document
from langchain_core.vectorstores import InMemoryVectorStore
from langchain_openai import OpenAIEmbeddings
from langchain_text_splitters import RecursiveCharacterTextSplitter

# ── 미리 해 두기 ──

docs = [
    Document(
        page_content="상품 수령 후 7일 이내, 착용 흔적이 없는 경우 "
        "같은 상품의 다른 사이즈로 1회 무료 교환할 수 있다.",
        metadata={"source": "교환 규정 제3조"},
    ),
    Document(
        page_content="주문은 평일 오후 2시 이전 결제 건까지 당일 출고한다. "
        "도서산간 지역은 1~2일이 더 걸린다.",
        metadata={"source": "배송 규정 제1조"},
    ),
]

splitter = RecursiveCharacterTextSplitter(chunk_size=500, chunk_overlap=50)
chunks = splitter.split_documents(docs)

vector_store = InMemoryVectorStore(
    embedding=OpenAIEmbeddings(model="text-embedding-3-small")
)
vector_store.add_documents(chunks)

# ── 질문이 오면 ──

question = "치수 변경 되나요?"
found = vector_store.similarity_search(question, k=2)
context = "\n\n".join(
    f"[{doc.metadata['source']}]\n{doc.page_content}" for doc in found
)

model = init_chat_model("anthropic:claude-sonnet-4-6")
answer = model.invoke(
    f"""아래 문서를 참고해서 질문에 답해줘.
문서에 없는 내용이면 모른다고 답해줘.

{context}

[질문]
{question}"""
)

print(answer.content)
예제라서 메모리에 저장하는 InMemoryVectorStore를 썼다. 실제 서비스라면 이 자리에 벡터 DB가 들어간다.
LangChain 없이도 만들 수 있다. 임베딩 API를 부르고, 벡터 사이의 거리를 계산하고, 가까운 걸 골라 프롬프트에 붙이면 끝이다. 문서가 몇백 개 수준이면 numpy 배열 하나로도 충분하다.
검색도 에이전트에게 맡기기
위 코드는 질문이 오면 무조건 한 번 검색한다. 그런데 영수가 이렇게 물으면 어떨까?
사이즈 교환하면 언제 다시 받아요?
교환 규정과 배송 규정을 둘 다 찾아야 한다. 반대로 "고마워요!" 같은 인사에는 검색이 필요 없다.
지난 글에서 본 "필요할 때 찾아 읽기"가 여기서 나온다. 검색을 도구로 만들어 에이전트에게 주면, 검색할지 말지와 무엇으로 검색할지를 모델이 정한다. 이걸 에이전틱 RAG(Agentic RAG)라고 부른다.
from langchain.agents import create_agent
from langchain.tools import tool


@tool
def search_policy(query: str) -> str:
    """쇼핑몰 규정(환불, 교환, 배송)에서 질문과 관련된 조항을 검색한다."""
    found = vector_store.similarity_search(query, k=2)
    return "\n\n".join(
        f"[{doc.metadata['source']}]\n{doc.page_content}" for doc in found
    )


agent = create_agent(
    model="anthropic:claude-sonnet-4-6",
    tools=[search_policy],
    system_prompt=(
        "너는 쇼핑몰 상담원이야. 규정에 관한 질문은 반드시 search_policy로 찾아보고, "
        "답할 때 근거가 된 조항을 함께 알려줘."
    ),
)

result = agent.invoke({
    "messages": [
        {"role": "user", "content": "사이즈 교환하면 언제 다시 받아요?"}
    ]
})

print(result["messages"][-1].content)
모델은 "사이즈 교환"으로 한 번, "배송 기간"으로 한 번 검색하고 두 조항을 합쳐서 답한다. 대신 모델 호출이 늘어나니 느리고 비싸다. 질문이 대부분 한 번 검색으로 끝나는 서비스라면 처음 방식이 낫다.
엉뚱한 걸 찾아오면
예제는 잘 돌아간다. 문제는 실제 문서 수십만 건을 넣었을 때다.
RAG의 답은 검색 결과보다 좋아질 수 없다. 엉뚱한 청크를 찾아오면 모델은 그걸 읽고 엉뚱하게 답한다. 지난 글에서 본 것처럼 모델은 컨텍스트에 든 걸 믿으니까, 틀린 근거를 찾아 주면 오히려 더 자신 있게 틀린다.
자주 부딪히는 문제는 이렇다.
청크가 문맥을 잃는다. "7일 이내 1회 무료"라는 문장만 떼어 놓으면 교환 얘기인지 반품 얘기인지 알 수 없다. 문서 제목이나 앞 문단에 있던 정보가 잘려 나간 탓이다.
엉뚱한 종류의 문서가 섞인다. 영수는 교환 규정을 물었는데, 리뷰 중에 "사이즈 교환했더니 3일 걸렸어요" 같은 문장이 뜻이 비슷하다는 이유로 같이 걸려 온다. 지난봄에 바뀌기 전의 옛 교환 규정이 걸릴 수도 있다. 뜻만 보고 찾으면 이걸 구분할 수 없다.
그래서 청크마다 의미 있는 꼬리표를 붙여 둔다. 문서 종류, 관련 상품, 시행일, 열람 권한 같은 것들이다. 이걸 시맨틱 메타데이터(Semantic Metadata)라고 부르고, 검색할 때는 뜻으로 찾기 전에 꼬리표로 먼저 거른다.
Document(
    page_content="상품 수령 후 7일 이내, 착용 흔적이 없는 경우 ...",
    metadata={
        "source": "교환 규정 제3조",
        "type": "policy",
        "status": "current",
        "effective_from": "2026-03-01",
    },
)

found = vector_store.similarity_search(
    "치수 변경 되나요?",
    k=2,
    filter=lambda doc: doc.metadata["type"] == "policy"
    and doc.metadata["status"] == "current",
)
InMemoryVectorStore는 필터를 함수로 받는다. 벡터 DB마다 필터 문법은 다르지만 하는 일은 같다. 권한 문제도 여기서 푼다. 상담 챗봇이 내부 정산 문서를 고객에게 읊으면 곤란하니, 열람 권한 꼬리표로 거르면 볼 수 없는 문서는 아예 컨텍스트에 들어가지 않는다.
꼬리표 조건을 LLM이 질문에서 직접 뽑게 할 수도 있다. 운영팀이 "지난달 러닝화 리뷰 중에 배송 불만만 보여줘"라고 물으면, LLM이 이걸 "종류 = 리뷰, 상품 = 러닝화, 날짜 = 지난달"이라는 필터와 "배송 불만"이라는 검색어로 나눈다. 이런 방식을 셀프 쿼리(Self-query) 검색이라고 부른다.
정확한 단어를 못 찾는다. 임베딩은 뜻이 비슷한 걸 잘 찾지만, 상품 코드 NK-270-BLK나 주문 번호처럼 글자가 정확히 맞아야 하는 검색에는 약하다. 그래서 BM25 같은 전통적인 키워드 검색을 같이 돌려서 결과를 합치는 하이브리드 검색을 많이 쓴다.
순서가 정확하지 않다. 벡터 검색은 빠르지만 대충 비슷한 것들을 넓게 가져온다. 그래서 후보를 넉넉히 가져온 다음, 질문과 하나하나 짝지어 비교해서 순서를 다시 매기는 리랭킹(Reranking)을 붙인다.
Anthropic은 Contextual Retrieval에서 이 방법들을 하나씩 더해 가며 효과를 쟀다. 먼저 임베딩하기 전에 LLM으로 청크마다 "이 청크는 ACME사의 2023년 2분기 실적 보고서 중 일부다" 같은 짧은 설명을 붙였다.
| 방법 | 검색 실패율 감소 |
|---|---|
| 청크에 문맥 설명 붙이기 | 35% |
| + 키워드 검색(BM25) 함께 쓰기 | 49% |
| + 리랭킹 | 67% |
그리고 하나 더 있다. 청크 크기를 바꾸고 임베딩 모델을 바꿔도 나아졌는지 감으로만 판단하는 경우가 많다. 질문과 정답 문서를 짝지은 평가 세트를 몇십 개라도 만들어 두자. 검색이 정답 문서를 찾아왔는지, 답이 문서 내용과 맞는지를 따로 봐야 어디를 고칠지 보인다.
조각으로는 답할 수 없는 질문
여기까지 잘 만들었다고 해 보자. 영수 같은 고객의 질문에는 정확한 조항을 찾아 잘 답한다.
그런데 운영팀이 챗봇에 이렇게 묻는다.
요즘 고객 불만이 주로 뭐야?
답은 리뷰와 문의 50만 건 전체에 흩어져 있다. RAG는 질문과 비슷한 청크를 몇 개 골라 온다. "불만"이라는 단어와 가까운 리뷰 다섯 개쯤을 읽고 답하는 셈이다. 50만 건을 훑어야 나오는 답을 다섯 건으로 만들 수는 없다.
이런 질문도 어렵다.
영수가 산 러닝화랑 같은 공장에서 만든 제품 중에 최근 불량 문의가 몰린 게 있어?
영수의 주문 내역, 상품 정보의 생산 공장, 다른 상품의 문의 내역을 차례로 이어 가야 답이 나온다. 각 정보는 서로 다른 문서에 있고, 어느 하나도 질문과 비슷하게 생기지 않았다. 비슷한 조각을 찾는 방식으로는 이 연결을 따라갈 수 없다.
GraphRAG, 조각을 이어서 지도를 만든다
GraphRAG는 이 문제를 풀려고 나온 방법이다. Microsoft Research가 2024년 「From Local to Global」 논문으로 발표하고 오픈소스로 공개했다.
일반 RAG가 문서를 잘라서 그대로 쌓아 둔다면, GraphRAG는 문서를 읽고 그 안의 관계를 뽑아 지도를 만든다.
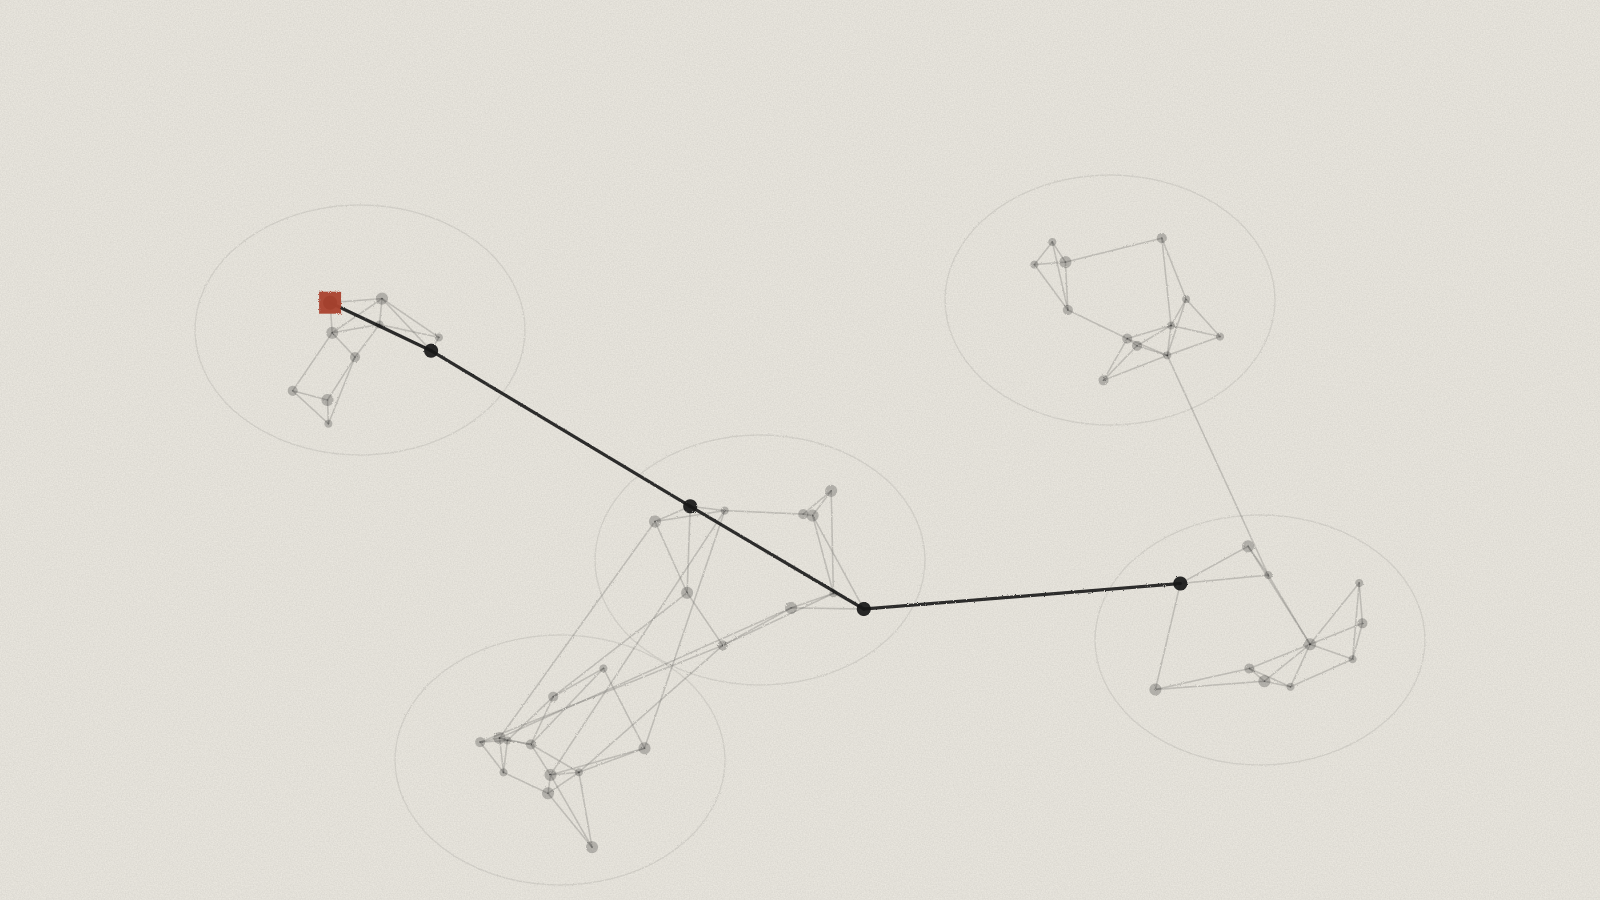
1. 관계 뽑기. LLM이 청크를 하나씩 읽으며 등장하는 대상(엔티티)과 그 사이의 관계를 뽑는다.
영수 ──구매──▶ 러닝화 X
러닝화 X ──생산──▶ A공장
러닝화 Y ──생산──▶ A공장
리뷰 #48213 ──불만──▶ 러닝화 Y : "밑창이 2주 만에 떨어짐"
리뷰 #50991 ──불만──▶ 러닝화 Y : "밑창 접착 불량"
이렇게 뽑은 관계를 모으면 지식 그래프가 된다.
여기서 하나 정해 둘 게 있다. LLM에게 관계를 마음대로 뽑게 하면 같은 관계가 여러 이름으로 그려진다. 어떤 청크에서는 "생산", 다른 청크에서는 "제조", 또 다른 곳에서는 "만든 곳"이 된다. "A공장"과 "에이 공장"이 서로 다른 점으로 찍히기도 한다. 그러면 이어져야 할 길이 끊긴 지도가 된다.
그래서 어떤 종류의 대상과 관계가 있는지 미리 정의해 둔다.
대상   고객, 상품, 공장, 리뷰
관계   고객 ──구매──▶ 상품
       상품 ──생산──▶ 공장
       리뷰 ──불만──▶ 상품
이렇게 데이터에 나오는 개념과 관계의 종류를 정의한 틀을 온톨로지(Ontology)라고 부르고, 회사에 따라서는 시맨틱 레이어(Semantic Layer)라는 이름으로 관리하기도 한다. LLM은 이 틀 안에서만 관계를 뽑고, 같은 공장은 같은 이름으로 합친다. 앞에서 본 시맨틱 메타데이터가 청크 하나하나에 붙이는 꼬리표라면, 온톨로지는 지도 전체의 범례다.
2. 무리 짓기. 그래프에서 서로 촘촘하게 연결된 것끼리 무리(커뮤니티)로 묶는다. "A공장 러닝화와 밑창 불량" 같은 무리가 생기고, 그 안에 더 작은 무리가 생기는 식으로 계층이 만들어진다.
3. 미리 요약해 두기. LLM이 무리마다 요약을 미리 써 둔다. "A공장에서 생산한 러닝화 3종에 최근 한 달간 밑창 분리 문의가 집중됨" 같은 요약이다.
질문이 들어오면 종류에 따라 다르게 찾는다.
"요즘 고객 불만이 주로 뭐야?"            → 전체 질문
  무리별 요약 각각에서 부분 답을 만들고 (map)
  부분 답들을 하나로 합친다 (reduce)

"영수 러닝화랑 같은 공장 제품은?"          → 특정 대상 질문
  영수 → 러닝화 X → A공장 → 러닝화 Y → 불량 문의
  그래프의 연결을 따라가며 관련 정보를 모은다
전체를 묻는 질문에는 미리 써 둔 무리별 요약을 읽는다. 리뷰 50만 건을 다시 뒤질 필요가 없다. 특정 대상을 묻는 질문에는 그래프의 선을 따라간다. 논문은 100만 토큰 규모의 데이터셋에서 이런 전체 질문에 대해 일반 RAG보다 답의 포괄성과 다양성이 크게 나아졌다고 보고했다.
대신 비싸다
공짜는 아니다. 관계를 뽑고 요약을 쓰려면 미리 해 두는 단계에서 LLM이 문서 전체를 한 번씩 읽어야 한다. 일반 RAG의 인덱싱이 임베딩 API를 부르는 정도라면, GraphRAG는 문서 전체에 LLM을 돌린다. 문서가 바뀌면 그래프와 요약도 다시 만들어야 한다.
그래프의 품질도 LLM이 관계를 얼마나 잘 뽑느냐에 달려 있다. 잘못 뽑힌 관계는 지도에 없는 길을 그려 넣는다. 온톨로지를 먼저 정해 두는 이유가 여기 있다.
Microsoft도 이 비용을 문제로 봤다. 2024년 11월 발표한 LazyGraphRAG는 요약을 미리 써 두지 않고 질문이 들어왔을 때 LLM을 쓰는 방식으로, 인덱싱 비용을 일반 벡터 RAG 수준(기존 GraphRAG의 0.1%)으로 낮췄다고 밝혔다.
그래서 뭘 써야 할까
문서가 적다면 RAG부터 만들 이유가 없다. Anthropic은 지식 베이스가 20만 토큰(약 500페이지)보다 작으면 전부 프롬프트에 넣는 방법을 권한다. 프롬프트 캐싱을 쓰면 비용도 꽤 줄어든다.
문서가 많고, 질문이 "교환 되나요?"처럼 특정 사실을 찾는 쪽이라면 일반 RAG로 충분하다. 벡터 검색에 키워드 검색과 리랭킹을 붙이고, 평가 세트로 검색 품질을 챙기는 게 먼저다.
"요즘 불만이 뭐야?"처럼 데이터 전체를 훑어야 하는 질문이나, 여러 문서에 걸친 관계를 따라가야 하는 질문이 중요하다면 그때 GraphRAG를 검토한다. 인덱싱 비용과 그래프를 관리하는 수고를 감당할 만큼 그 질문이 중요한지가 기준이다.
어느 쪽이든 하는 일은 같다. 지난 글의 상자, 그러니까 모델 앞에 놓이는 컨텍스트에 지금 질문에 필요한 것만 골라 넣는 일이다. RAG는 그 골라 넣기를 검색으로 하고, GraphRAG는 미리 그려 둔 지도로 한다.
영수의 질문에 챗봇은 이제 이렇게 답한다.
네, 수령 후 7일 이내이고 착용 흔적이 없다면 다른 사이즈로 1회 무료 교환할 수 있어요. (교환 규정 제3조)
RAG 말고도 AI 개발 관련 글을 더 찾아보고 싶다면 AI 뉴스 데일리의 AI 개발글도 둘러보자. 국내외 기업과 개발자 기술 블로그의 AI 개발 글을 요약과 함께 모아 두었다.
참고 자료
- Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks – Patrick Lewis 외, 2020
- From Local to Global: A Graph RAG Approach to Query-Focused Summarization – Darren Edge 외, Microsoft Research, 2024
- GraphRAG 공식 문서 – Microsoft
- LazyGraphRAG: Setting a new standard for quality and cost – Microsoft Research, 2024.11.25
- Introducing Contextual Retrieval – Anthropic, 2024.09.19
- LangChain 공식 문서 – Build a RAG agent